最近深入体验了一下 LocateAnything 和 Grounding DINO。
这两种方案都可以解决开放词汇目标检测的问题。比如,我们想在一张图片中找到篮球的位置,只需要告诉模型要找“篮球”,不需要专门针对篮球重新训练一个目标检测模型。
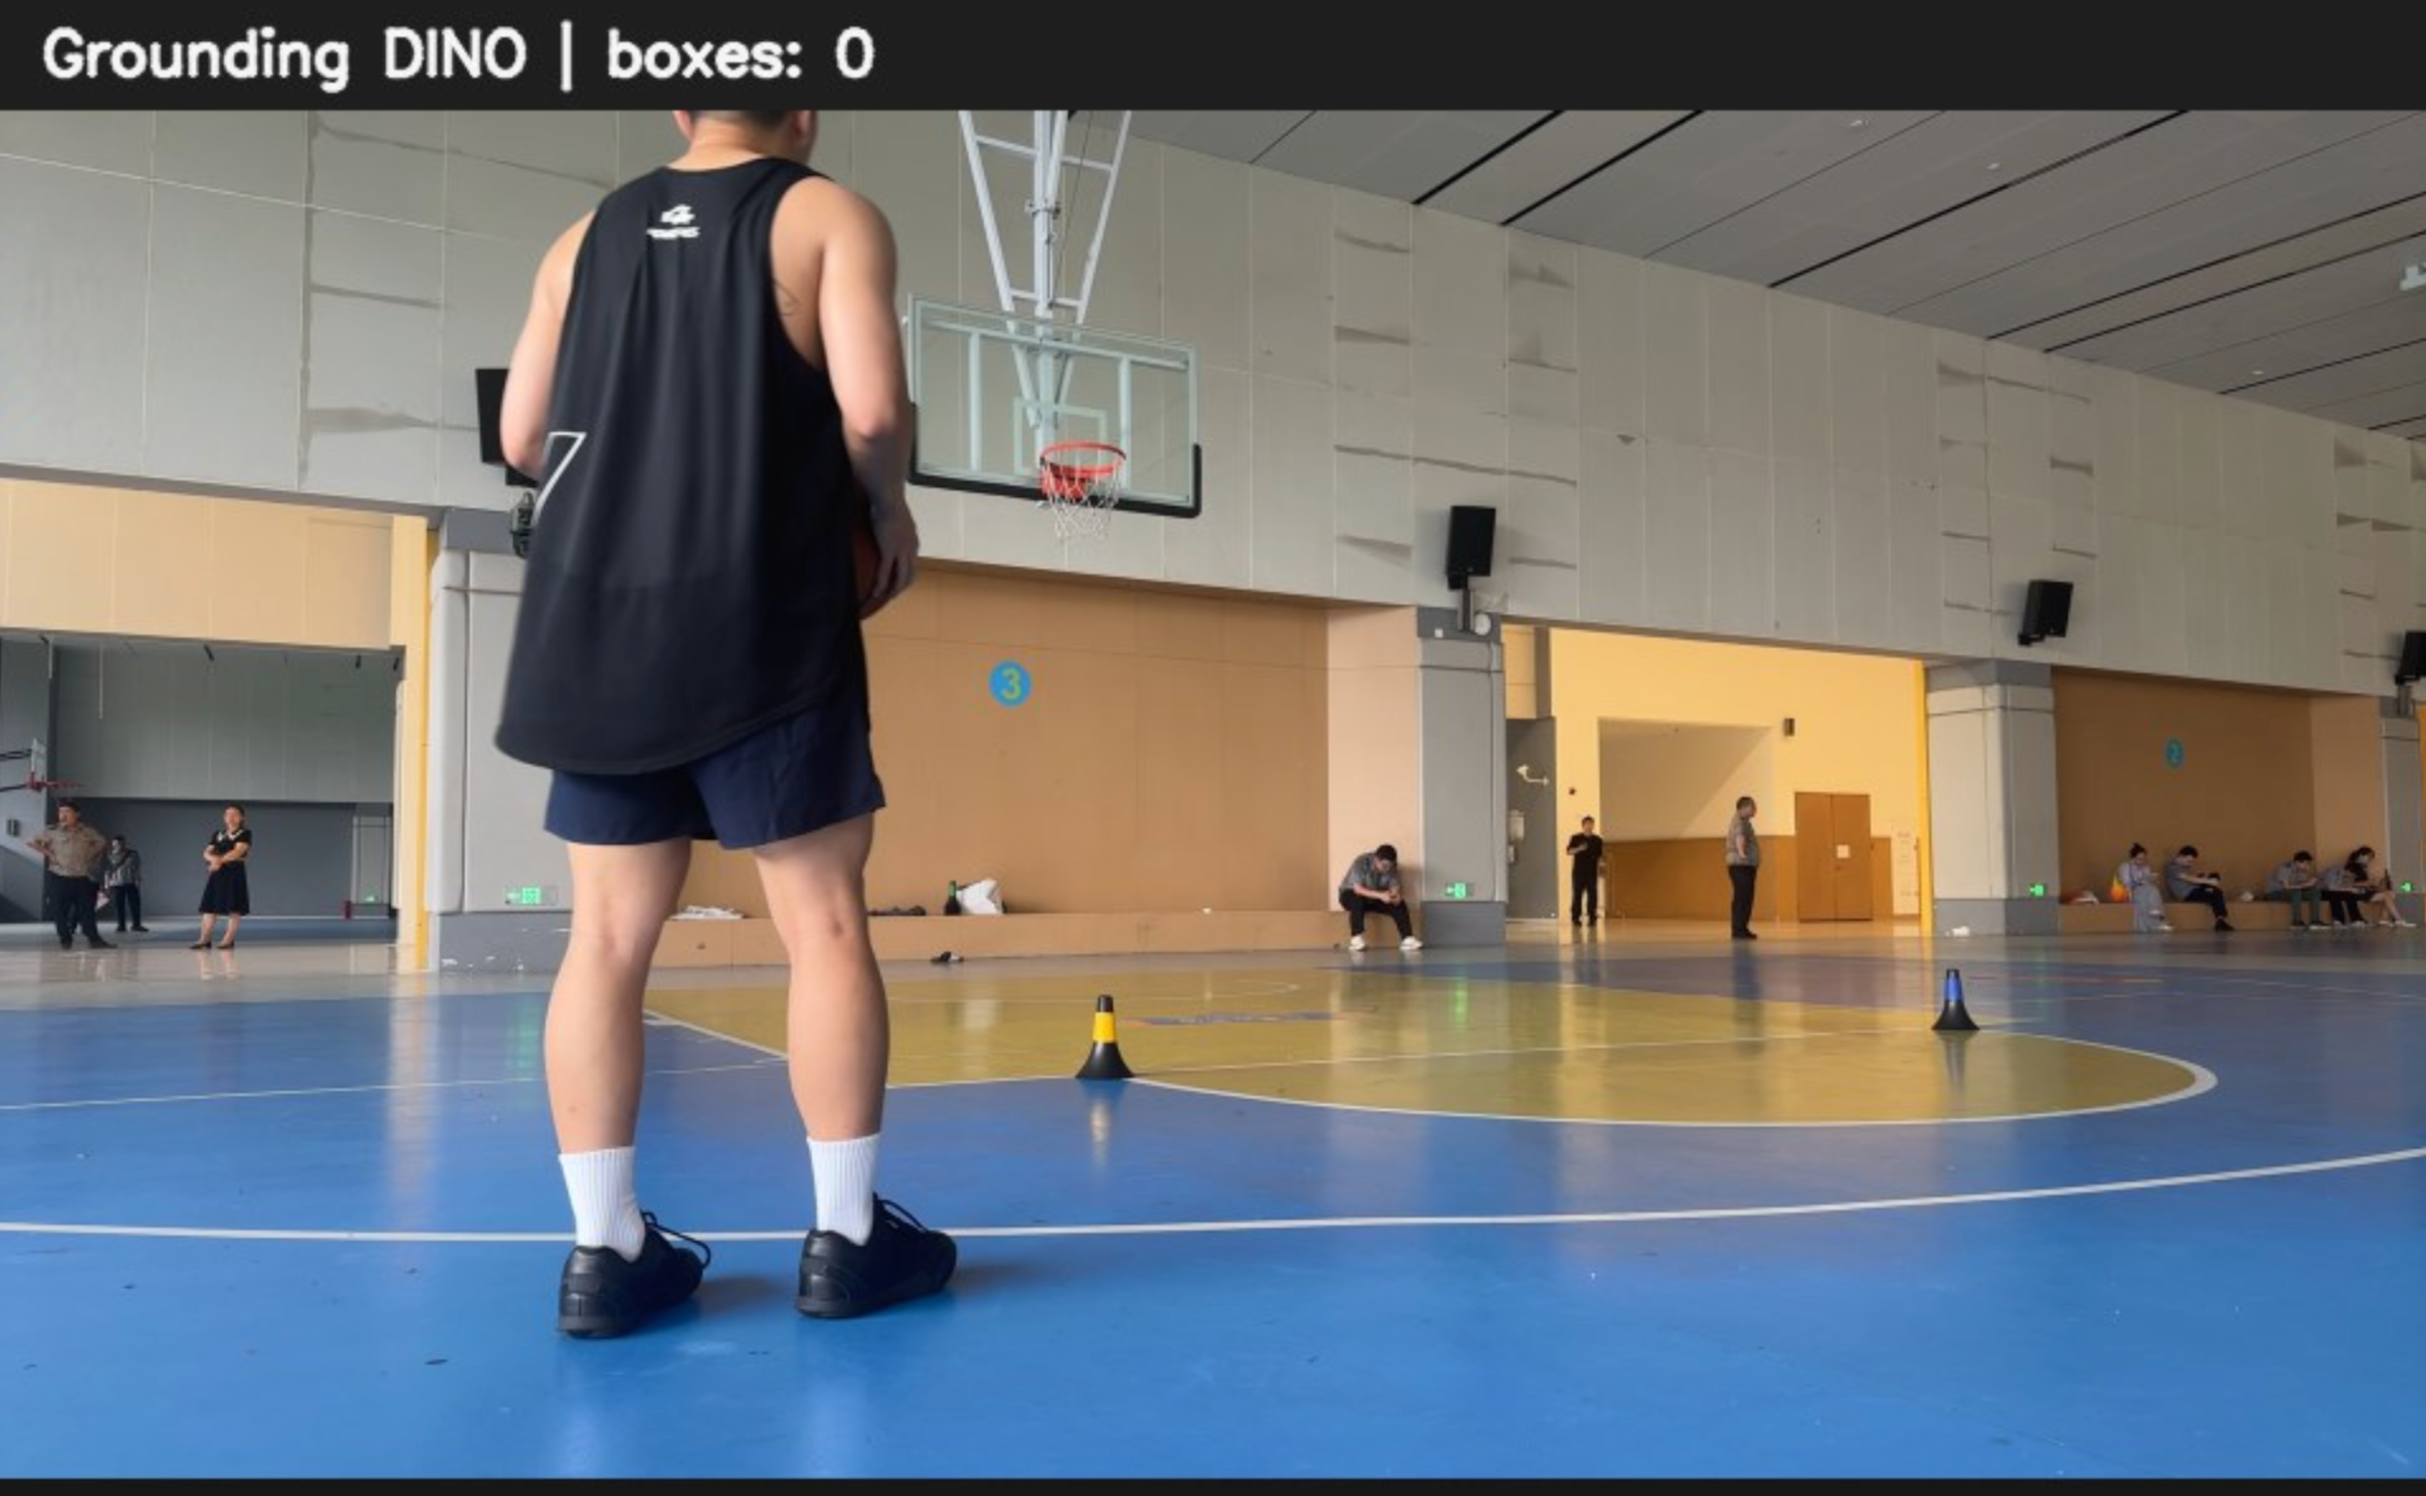
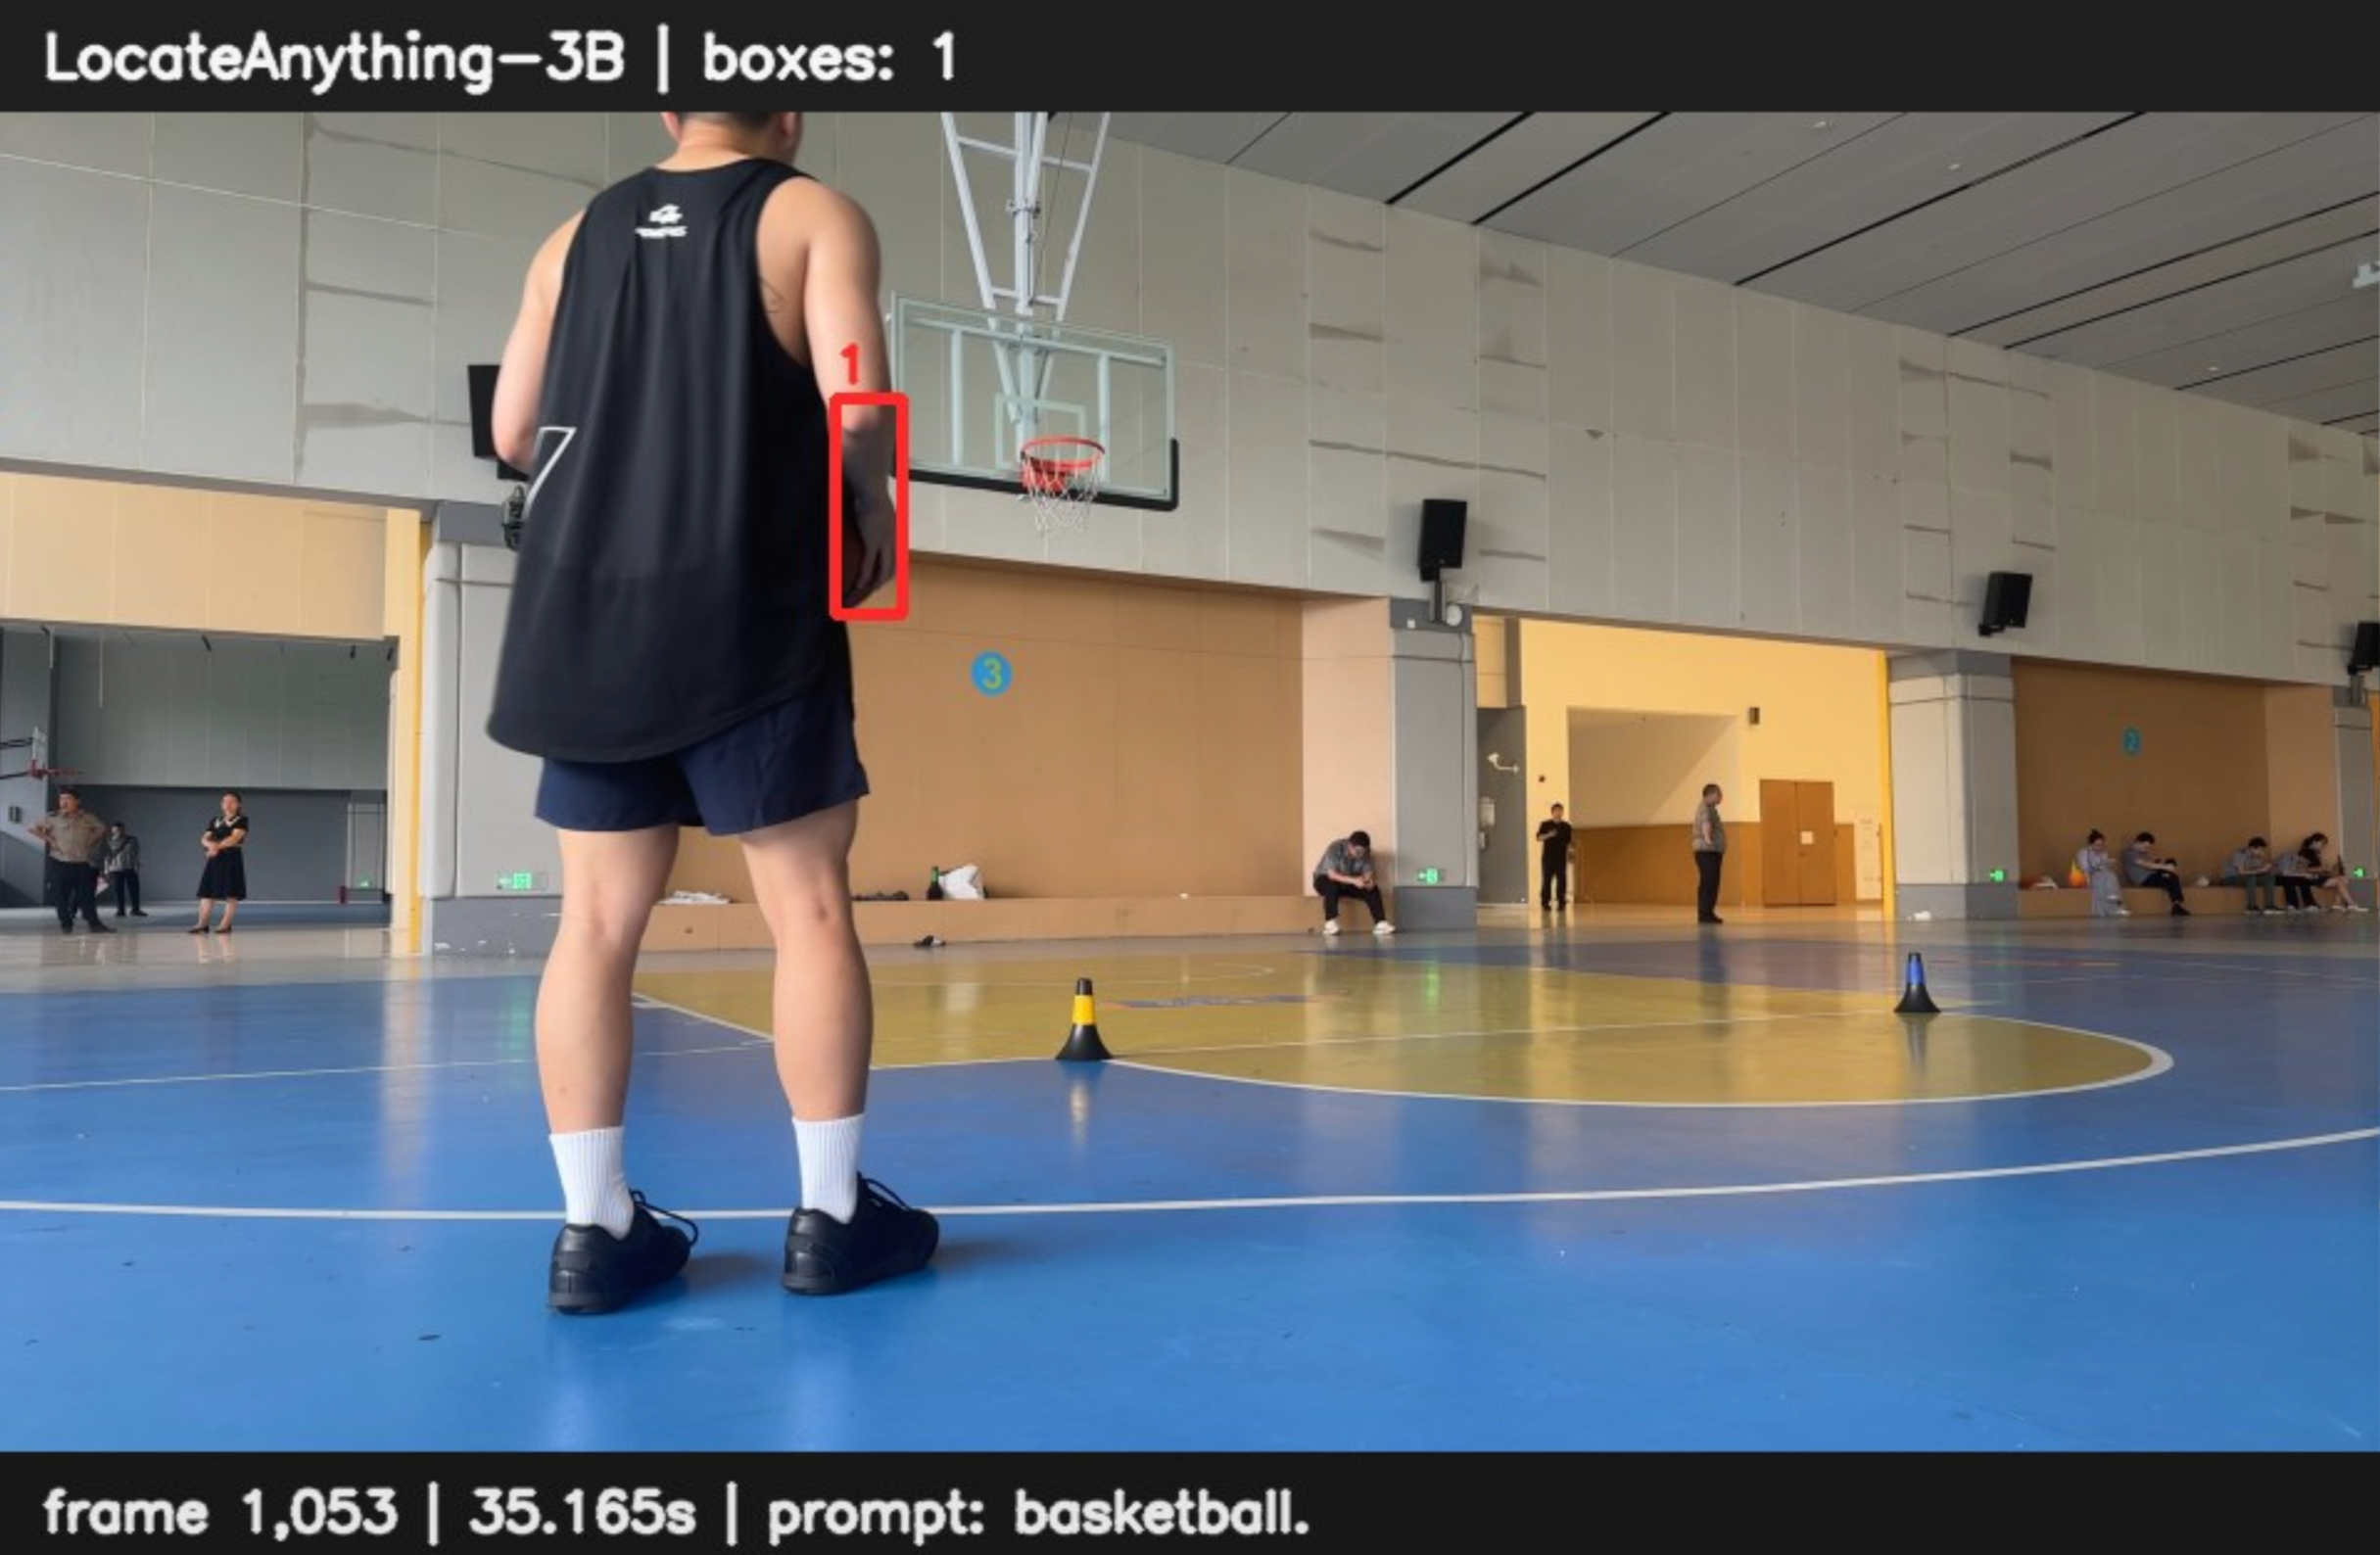
经过一段时间的测试,我发现这两种方案基本都能满足我的需求:在一张图片中识别并定位篮球。
那么,这两种方案应该怎么选?
如果检测目标相对简单,而且比较在意处理速度,我会更推荐 Grounding DINO。
因为对于篮球这类相对明确的目标,两者都能够完成检测,但 Grounding DINO 的速度明显更快。
例如,在我的测试环境中,对一张 960 分辨率的图片进行检测,Grounding DINO 大约需要 500 毫秒,而 LocateAnything 大约需要 12 秒。
两者在速度上的差距非常明显。
但如果你对处理时间没有那么敏感,同时检测的目标比较小,或者存在明显遮挡,那么 LocateAnything 会更有优势。
经过多次测试,我发现,在小目标和遮挡目标的定位能力上,LocateAnything 的表现整体要比 Grounding DINO 更稳定一些。
所以简单总结:
追求速度、目标比较明确:优先考虑 Grounding DINO。
目标较小、遮挡较多,对速度要求不高:可以考虑 LocateAnything。
以上是我实际测试下来的一些体验,希望对正在选择这两种方案的人有所帮助。
有问题请留言~
在 GitHub 查看讨论